Architektura AI #194
Gorzka lekcja i paradoks Moraveca
termin oryginalny: the bitter lesson and Moravec's paradox (ang.) · gorzka lekcja Suttona, paradoks Moraveca, the bitter lesson
Rodowód środkowoeuropejski: 1 wątek (antycypacja) · 1949–2019 · przejdź do dokumentacji ↓
Definicja robocza
Gorzka lekcja (the bitter lesson) oraz paradoks Moraveca (Moravec’s paradox) to dwie komplementarne zasady porządkujące historię i ograniczenia sztucznej inteligencji. Gorzka lekcja, sformułowana przez współtwórcę uczenia ze wzmocnieniem Richarda S. Suttona, głosi, że w długim horyzoncie czasowym ogólne metody statystyczne skalujące się z wykładniczym wzrostem mocy obliczeniowej — przeszukiwanie (search) i uczenie (learning) — zawsze pokonują systemy, w które badacze próbowali ręcznie wpisać ludzką wiedzę ekspercką. Paradoks Moraveca, opisany przez robotyka Hansa Moraveca, wskazuje z kolei na odwróconą hierarchię trudności zadań: to, co dla człowieka wymaga wieloletnich studiów (dowodzenie twierdzeń, szachy, analiza prawna), jest dla maszyn stosunkowo łatwe, natomiast to, co człowiek i zwierzęta wykonują bezwiednie (orientacja w zagraconym pokoju, złożenie ręcznika, złapanie piłki), okazuje się obliczeniowo najtrudniejsze. Zestawienie obu pojęć tłumaczy krajobraz współczesnej technologii: żyjemy w świecie, w którym algorytmy zdają egzaminy adwokackie i rozwiązują strukturę białek, podczas gdy robot domowy ma problem z wyjęciem delikatnej szklanki ze zmywarki.
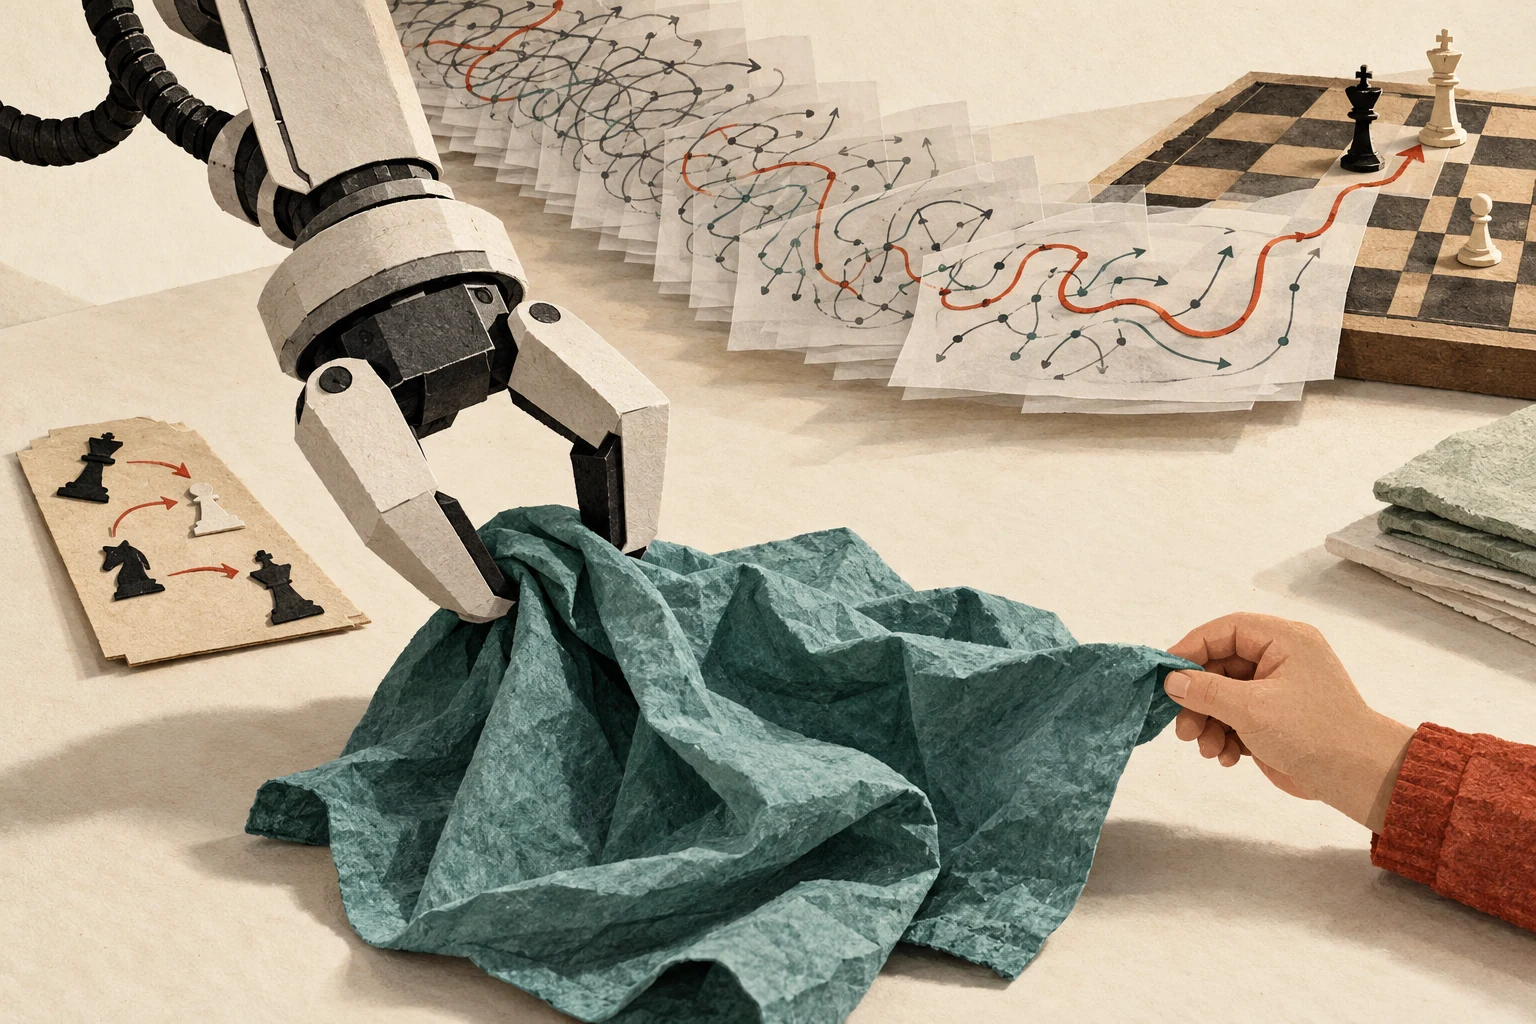
Nagromadzone próby i odłożony sztywny szablon odsyłają do przewagi ogólnych metod uczenia i wyszukiwania nad ręcznie wpisaną wiedzą. Szachy obok kłopotu z miękką tkaniną przypominają paradoks Moraveca. Plansza łączy dwa pokrewne spostrzeżenia; nie dowodzi, że samo zwiększanie obliczeń rozwiązuje każde zadanie.
Ilustracja z pomocą AI · metafora pojęcia Zobacz w quizie →Geneza i rodowód
Paradoks Moraveca narodził się w latach 80. XX wieku z frustracji pionierów robotyki (Hansa Moraveca, Rodneya Brooksa, Marvina Minsky’ego) wobec założeń symbolicznej sztucznej inteligencji (GOFAI). Twórcy pierwszych systemów AI w latach 50. i 60. sądzili, że skoro komputer opanował rachunek logiczny i warcaby, to widzenie komputerowe i chwytanie przedmiotów będzie prostym zadaniem na jedno lato. Moravec w książce Mind Children (1988) podał ewolucyjne wyjaśnienie tej pomyłki: abstrakcyjne myślenie logiczne liczy najwyżej sto tysięcy lat, przez co nie ma w naszym mózgu głębokiej, wyspecjalizowanej maszynerii; natomiast percepcja wzrokowa i kontrola motoryczna były rzeźbione przez dobór naturalny przez pół miliarda lat i angażują miliardy nieświadomych obwodów neuronalnych. Trzy dekady później, w marcu 2019 r., kanadyjski informatyk Richard S. Sutton (laureat Nagrody Turinga z 2024 r.) opublikował esej The Bitter Lesson. Podsumował w nim kolejne fale rozwoju AI — od szachów (Deep Blue 1997) i Go (AlphaGo i AlphaZero 2016–2017) po rozpoznawanie mowy i widzenie komputerowe: za każdym razem badacze najpierw osiągali postępy przez wpisywanie do programu ludzkich heurystyk, lecz gdy prawo Moore’a obniżało koszt obliczeń o kolejne rzędy wielkości, brutalne przeszukiwanie i uczenie od zera (tabula rasa) wypierało konstrukcje ekspertów.
Rodowód środkowoeuropejski
Matematyczny fundament jednego z dwóch filarów gorzkiej lekcji Suttona — wielkoskalowego, probabilistycznego przeszukiwania przestrzeni stanów (search) — ma bezpośredni rodowód w lwowskiej i budapeszteńskiej szkole matematycznej. W latach 1946–1949 Stanisław Ulam, wykształcony na Politechnice Lwowskiej i uformowany intelektualnie przy stolikach Kawiarni Szkockiej we Lwowie, wspólnie z wychowankiem gimnazjum i uniwersytetu w Budapeszcie Johnem von Neumannem opracował w Los Alamos metodę Monte Carlo. Punkt wyjścia Ulama był uderzająco bliski późniejszej intuicji Suttona: układając podczas rekonwalescencji pasjansa, Ulam zauważył, że zamiast mozolnie wyprowadzać wzory kombinatoryczne na prawdopodobieństwo wyjścia gry, znacznie skuteczniej jest rozegrać na nowej elektronicznej maszynie ENIAC tysiące losowych partii i zliczyć statystyczny rozkład wyników. To właśnie rozwinięcie tej idei — algorytm przeszukiwania drzewa metodą Monte Carlo (Monte Carlo Tree Search, MCTS) połączony z głębokimi sieciami neuronowymi — pozwoliło systemowi AlphaZero nauczyć się nadludzkiej gry w Go i szachy bez jakiejkolwiek ludzkiej wiedzy o debiutach. Przy okazji tego hasła należy odnotować istotne rozróżnienie metodologiczne: choć Hans Moravec urodził się w 1948 r. w Kautzen w Dolnej Austrii, w wieku pięciu lat wyemigrował z rodzicami do Kanady i tam przeszedł całą formację szkolną i akademicką; jego przypadek ilustruje regułę, że o rodowodzie intelektualnym decyduje środowisko kształcenia, a nie samo miejsce urodzenia w metryce.
Udokumentowany rodowód regionalny · Związek: 1. Opracowanie: październik 2026.
-
antycypacja 70 lat
Źródło w regionie: Stanisław Ulam (we współpracy z Johnem von Neumannem), „The Monte Carlo Method (oraz eksperymenty z automatami i programami szachowymi w Los Alamos)”; Lwów / Budapeszt / Los Alamos, 1949
Obieg globalny: gorzka lekcja o przewadze skalowalnego przeszukiwania nad wiedzą ekspercką (The Bitter Lesson) — Richard S. Sutton, 2019
antycypacja
70 latStanisław Ulam (we współpracy z Johnem von Neumannem), „The Monte Carlo Method (oraz eksperymenty z automatami i programami szachowymi w Los Alamos)”
1949 · Lwów / Budapeszt / Los Alamos
gorzka lekcja o przewadze skalowalnego przeszukiwania nad wiedzą ekspercką (The Bitter Lesson)
2019 · Richard S. Sutton
- Teza i powiązanie
- Stanisław Ulam — ukształtowany matematycznie na Politechnice Lwowskiej i w kręgu Kawiarni Szkockiej (doktorat 1933) — wraz z ukształtowanym w Budapeszcie Johnem von Neumannem sformułował w latach 1946–1949 metodę Monte Carlo: zasadę zastępowania skomplikowanych wyprowadzeń analitycznych masowym, losowym próbkowaniem przestrzeni stanów na szybkich maszynach cyfrowych. To podejście (zastosowane później w algorytmach Monte Carlo Tree Search w AlphaGo) stanowi wcześniejsze sformułowanie myśli, którą Richard Sutton uogólnił w 2019 r. jako „gorzką lekcję” badań nad sztuczną inteligencją.
- Dokumentacja źródłowa
-
- źródło pierwotne Nicholas Metropolis, Stanisław Ulam, „The Monte Carlo Method”, Journal of the American Statistical Association, Vol. 44, No. 247, 1949, s. 335–341; s. 335–341: idea wykorzystania elektronicznych maszyn liczących do statystycznego próbkowania wielowymiarowej przestrzeni stanów zamiast równań różniczkowych i kombinatoryki analitycznej. doi.org ↗
- dokumentacja biograficzna Stanisław M. Ulam, „Adventures of a Mathematician”, Charles Scribner's Sons, New York 1976 (wyd. pol. „Przygody matematyka”, Prószyński i S-ka, Warszawa 1996); rozdz. 1–4 (formacja lwowska) oraz rozdz. 10–11 (narodziny metody Monte Carlo z problemu pasjansa i rozmowy z von Neumannem). archive.org ↗
- Kontekst historyczny
- Współautor pojęcia tytułowego Hans Moravec urodził się wprawdzie w 1948 r. w Kautzen w Dolnej Austrii, lecz wyemigrował z rodziną do Kanady w wieku pięciu lat (1953) i całą edukację odbył w Kanadzie oraz USA — zgodnie z regułą serwisu („formacja, nie urodzenie”) nie jest więc zaliczany do rodowodu środkowoeuropejskiego.
Dlaczego teraz
W latach 2019–2026 zderzenie gorzkiej lekcji z paradoksem Moraveca stało się główną osią sporu o przyszłość sztucznej inteligencji. Publikacja eseju Suttona zbiegła się z premierą modeli GPT-2 (2019) i GPT-3 (2020) oraz artykułem o prawach skalowania (Kaplan i in., 2020): laboratoria w Dolinie Krzemowej potraktowały „gorzką lekcję” jako uzasadnienie wielomiliardowych inwestycji w klastry obliczeniowe i porzucenia ręcznej inżynierii cech. W latach 2024–2026 wraz z modelami rozumującymi (OpenAI o1/o3, DeepSeek-R1) skalowanie obliczeń przeniosło się na etap wnioskowania (test-time compute), gdzie model poświęca tysiące tokenów na przeszukiwanie drzewa myśli przed udzieleniem odpowiedzi. Jednocześnie paradoks Moraveca wziął odwet na prognozach ekonomistów: podczas gdy w dekadzie 2010–2020 przewidywano, że automatyzacja najpierw zastąpi kierowców, hydraulików i magazynierów, a na końcu dotknie programistów i prawników, po 2022 r. nastąpiło odwrócenie tej kolejności — generatywna AI weszła do pracy biurowej, podczas gdy roboty wciąż zmagają się z chwytaniem nieregularnych obiektów.
Siła wyjaśniająca
Połączenie obu koncepcji wyjaśnia trzy zjawiska. Pierwszym jest historia przetwarzania języka naturalnego (NLP): przez dziesięciolecia lingwiści kodowali w systemach drzewa rozbioru gramatycznego i wyjątki fleksyjne (jak mówił żart badacza mowy Freda Jelinka: „Za każdym razem, gdy zwalniam lingwistę, wydajność mojego systemu rozpoznawania mowy rośnie”); gdy zastąpiono je architekturą Transformer trenowaną na bilionach słów, model sam odkrył strukturę języka dokładniej niż podręczniki. Drugim przykładem jest biologia strukturalna: przez pół wieku fizycy próbowali policzyć zwijanie białek z pierwszych zasad fizyki, aż system AlphaFold 2 (2020) rozwiązał problem przez wielkoskalowe uczenie wzorców z baz sekwencji. Trzecim przykładem — ilustrującym paradoks Moraveca — jest autonomiczna jazda: program wygrywający z mistrzem świata w szachy wymagał ułamka tej mocy obliczeniowej, jakiej potrzebuje samochód autonomiczny, by w deszczowy wieczór odróżnić foliową torbę niesioną przez wiatr od zwierzęcia na poboczu, bo szachy są światem zamkniętym o czystych regułach, a ulica światem otwartym wymagającym zmysłowego zakorzenienia.
Osie sporu
Czyste skalowanie i uczenie od zera (Sutton) kontra hybrydowe modele symboliczno-przyczynowe (Marcus, Pearl, Chollet)
Kognitywiści i badacze AI (Gary Marcus, Judea Pearl, François Chollet) argumentują, że gorzka lekcja stała się dogmatem siły brutalnej (brute force): ludzkie dziecko nie musi przeczytać całego internetu, by nauczyć się pojęcia przedmiotu, ponieważ ewolucja wyposażyła mózg we wrodzone założenia strukturalne (inductive biases). Najmocniejszy kontrargument: Zwolennicy podejścia Suttona odpowiadają, że próby ręcznego zaprogramowania „zdrowego rozsądku” okazywały się wąskim gardłem, a wrodzone reguły u dziecka są wynikiem trwającego setki milionów lat „treningu” ewolucyjnego zapisanego w architekturze kory mózgowej. Charakter sporu: rzeczowy — dotyczy tego, czy obecne sieci neuronowe potrafią wyuczyć się abstrakcyjnej przyczynowości z samych danych i interakcji, czy wymagają nowej klasy wbudowanych ograniczeń strukturalnych.
Bariera danych i energii kontra nieskończone skalowanie czasu wnioskowania (test-time compute)
Ekonomiści technologii zwracają uwagę, że gorzka lekcja z lat 1950–2020 opierała się na taniejącym krzemie oraz gotowym zasobie tekstów w internecie; po 2024 r. oba te zasoby napotkały ściany fizyczne — wyczerpanie wysokiej jakości danych tekstowych oraz limity mocy sieci energetycznych. Najmocniejszy kontrargument: Badacze uczenia ze wzmocnieniem (w tym Sutton) wskazują, że wyczerpanie statycznego tekstu kończy jedynie epokę biernego naśladowania człowieka; prawdziwa gorzka lekcja polega na przejściu do systemów generujących nowe doświadczenie przez działanie w środowisku, symulację i samodoskonalenie w czasie wnioskowania (jak AlphaZero). Charakter sporu: rzeczowy — spór o to, w jakich dziedzinach poza grami i kodowaniem możliwe jest stworzenie automatycznego weryfikatora nagrody pozwalającego modelowi uczyć się bez ludzkich danych.
Trwałość paradoksu Moraveca kontra rewolucja ucieleśnionych modeli bazowych w robotyce
Robotycy klasyczni podnoszą, że w świecie fizycznym nie da się powtórzyć recepty modeli językowych: w internecie leżały biliony zdań, natomiast nigdzie nie istnieje gotowy korpus biliona godzin zapisu sił nacisku ścięgien i dotyku dłoni, a symulacje cierpią na przepaść między symulacją a rzeczywistością (sim-to-real gap). Najmocniejszy kontrargument: Twórcy modeli wizyjno-językowo-działaniowych (VLA) z lat 2024–2026 dowodzą, że paradoks Moraveca zaczyna ustępować przed gorzką lekcją: gdy trenuje się wielki model multimodalny na wideo i teleoperacji robotów, maszyny zaczynają generalizować ruchy w nieznanym otoczeniu. Charakter sporu: rzeczowy — rozstrzyga się empirycznie w zależności od tego, czy transfer wiedzy z modeli wideo i symulatorów fizycznych wystarczy do pokonania deficytu danych sensomotorycznych.
Niedoceniany kąt
Dlaczego lekcja Suttona jest właściwie „gorzka”? Zwykle rozumie się to jako ranę narcystyczną dla naukowców, których kunsztowne algorytmy przegrywają z mnożeniem macierzy na tysiącach kart graficznych. Istnieje jednak głębszy, epistemologiczny wymiar tej goryczy: rozdzielenie zdolności do przewidywania od ludzkiego rozumienia naukowego. Przez trzysta lat nauki od czasów Newtona postęp techniczny szedł w parze ze zrozumieniem: aby zbudować lepszy most lub silnik, odkrywaliśmy zwięzłe prawa fizyki mieszczące się w głowie człowieka. Gorzka lekcja pokazuje natomiast, że w układach o wysokiej złożoności (język, biologia komórki, pogoda) rzeczywistość nie daje się skompresować do kilku eleganckich reguł; model złożony z biliona nieprzejrzystych wag działa lepiej dlatego, że rezygnuje z uproszczeń wymaganych przez ludzką potrzebę zrozumienia. Ceną za skuteczność narzędzia staje się to, że sam jego twórca przestaje rozumieć, jak ono w szczegółach rozwiązuje problem.
Jedno zdanie na wynos
Dla maszyn cyfrowych najtrudniejsze okazało się to, co ewolucja rozwiązała u zwierząt setki milionów lat temu bez udziału świadomości, a dla inżynierów najtrudniejsze okazało się pogodzenie z faktem, że brutalna skala obliczeń wygrywa z ich własną wiedzą ekspercką.
Sieć pojęć pokrewnych
Jak to pojęcie wzmacnia, ogranicza lub uzupełnia inne ramy analityczne w korpusie. Zobacz na grafie →
-
Prawa skalowania wzmacnia
Empiryczne prawa skalowania Kaplana i Chinchilli są matematyczną kodyfikacją gorzkiej lekcji Suttona: płynny wzrost inteligencji modelu jako funkcja potęgowa samej mocy obliczeniowej i rozmiaru danych.
-
Wiedza milcząca i paradoks Polanyiego uzupełnia
Paradoks Moraveca i paradoks Polanyiego to dwie strony tego samego medalu: percepcja i ruch są trudne do zaprogramowania w regułach właśnie dlatego, że stanowią wyewoluowaną przez miliard lat wiedzę milczącą organizmu.
-
Enaktywizm wzmacnia
Trudność robotyki w opanowaniu prostych czynności fizycznych (paradoks Moraveca) potwierdza główną tezę enaktywizmu, że podstawowe poznanie nie jest manipulacją symbolami przy biurku, lecz ucieleśnionym sprzężeniem sensomotorycznym ze środowiskiem.
-
Modele bazowe wzmacnia
Zastąpienie setek wyspecjalizowanych algorytmów lingwistycznych jednym wielkim modelem bazowym trenowanym od końca do końca na surowym tekście jest najbardziej spektakularnym triumfem gorzkiej lekcji w XXI wieku.
-
Sztuczna inteligencja ogólna (AGI) w napięciu
Spór o drogę do AGI rozgrywa się dziś na przecięciu obu pojęć: czy samo dalsze skalowanie mocy obliczeniowej (gorzka lekcja) przełamie wreszcie barierę ucieleśnionej percepcji i manipulacji światem fizycznym (paradoks Moraveca).
-
Przetwarzanie predykcyjne uzupełnia
Teoria przetwarzania predykcyjnego wyjaśnia, jak mózg biologiczny łączy obie strony równania: używa jednego ogólnego algorytmu minimalizacji błędu predykcji wyuczonego na miliardach bodźców zmysłowych.
-
Banalność zła i problem wielu rąk uzupełnia
Triumf gorzkiej lekcji pogłębia etyczny problem wielu rąk: gdy ręcznie pisane, przejrzyste reguły inżynierów zostają zastąpione przez miliardy nieczytelnych wag wyuczonych na danych z całej sieci, rozmywa się indywidualna odpowiedzialność za pojedynczą decyzję systemu.
Kanon lektur i most przekładowy
Kluczowe prace założycielskie, wprowadzenia i głosy krytyczne — wraz z informacją o dostępności wydań w języku polskim i angielskim.
-
tekst założycielski 2019 · angielski
Richard S. Sutton, The Bitter Lesson
Krótki, dwustronicowy esej z marca 2019 r., który stał się nieformalnym manifestem współczesnych laboratoriów AI: dlaczego metody ogólne skalujące się z mocą obliczeniową zawsze pokonują ręcznie kodowaną wiedzę ekspercką.
Po polsku: brak polskiego wydania
Po angielsku: tekst oryginalny po angielsku
-
tekst założycielski 1988 · angielski
Hans Moravec, Mind Children: The Future of Robot and Human Intelligence
Książka, w której pionier robotyki z Carnegie Mellon sformułował paradoks ewolucyjny: to, co wymaga od człowieka najwyższego wysiłku świadomego, jest dla komputera łatwe, a to, co robimy bezwiednie, jest ekstremalnie trudne.
Po polsku: „Człowiek czy maszyna. Przyszłość robotów i ludzkiej inteligencji”, Państwowy Instytut Wydawniczy 1995, przeł. Tadeusz Pańkowski
Po angielsku: tekst oryginalny po angielsku
-
perspektywa krytyczna 2020 · angielski
Gary Marcus, The Next Decade in AI: Four Steps Towards Robust Artificial Intelligence
Programowa polemika z radykalnym empiryzmem głębokiego uczenia, dowodząca, że bez wbudowanych struktur symbolicznych, modeli przyczynowości i wiedzy wrodzonej samo skalowanie pozostanie kruche i zawodne.
Po polsku: brak polskiego wydania
Po angielsku: tekst oryginalny po angielsku
-
wprowadzenie i synteza 2019 · angielski
Melanie Mitchell, Artificial Intelligence: A Guide for Thinking Humans
Znakomite wprowadzenie pokazujące na konkretnych przykładach, jak współczesne sieci neuronowe wygrywają w zadaniach wąskich dzięki mocy obliczeniowej, a jednocześnie potykają się o brak zdroworozsądkowego rozumienia świata fizycznego.
Po polsku: brak polskiego wydania
Po angielsku: tekst oryginalny po angielsku
-
z innej dziedziny 1994 · angielski
Steven Pinker, The Language Instinct: How the Mind Creates Language
Książka z psychologii ewolucyjnej i kognitywistyki, w której Pinker nadał spostrzeżeniu Moraveca nazwę „paradoksu Moraveca” i wyjaśnił je doborem naturalnym działającym przez setki milionów lat na aparat percepcyjno-ruchowy.
Po polsku: brak polskiego wydania
Po angielsku: tekst oryginalny po angielsku
-
z innej dziedziny 1990 · angielski
Rodney A. Brooks, Elephants Don't Play Chess
Klasyczny manifest robotyki behawioralnej wykazujący, że tradycyjna sztuczna inteligencja mylnie wzięła abstrakcyjne gry planszowe za istotę inteligencji, ignorując problem poruszania się i przetrwania w zmiennym otoczeniu.
Po polsku: brak polskiego wydania
Po angielsku: tekst oryginalny po angielsku
Cytaty źródłowe
The biggest lesson that can be read from 70 years of AI research is that general methods that leverage computation are ultimately the most effective, and by a large margin.
Najważniejsza lekcja, jaką można wyciągnąć z 70 lat badań nad sztuczną inteligencją, brzmi: ogólne metody wykorzystujące moc obliczeniową okazują się ostatecznie najskuteczniejsze, i to z ogromną przewagą. (przekład: przekład roboczy)
It is comparatively easy to make computers exhibit adult level performance on intelligence tests or playing checkers, and difficult or impossible to give them the skills of a one-year-old when it comes to perception and mobility.
Stosunkowo łatwo jest sprawić, by komputery osiągały poziom dorosłego człowieka w testach inteligencji lub grze w warcaby, natomiast niezwykle trudno lub wręcz nie sposób wyposażyć je w umiejętności rocznego dziecka w zakresie percepcji i poruszania się. (przekład: przekład roboczy)